
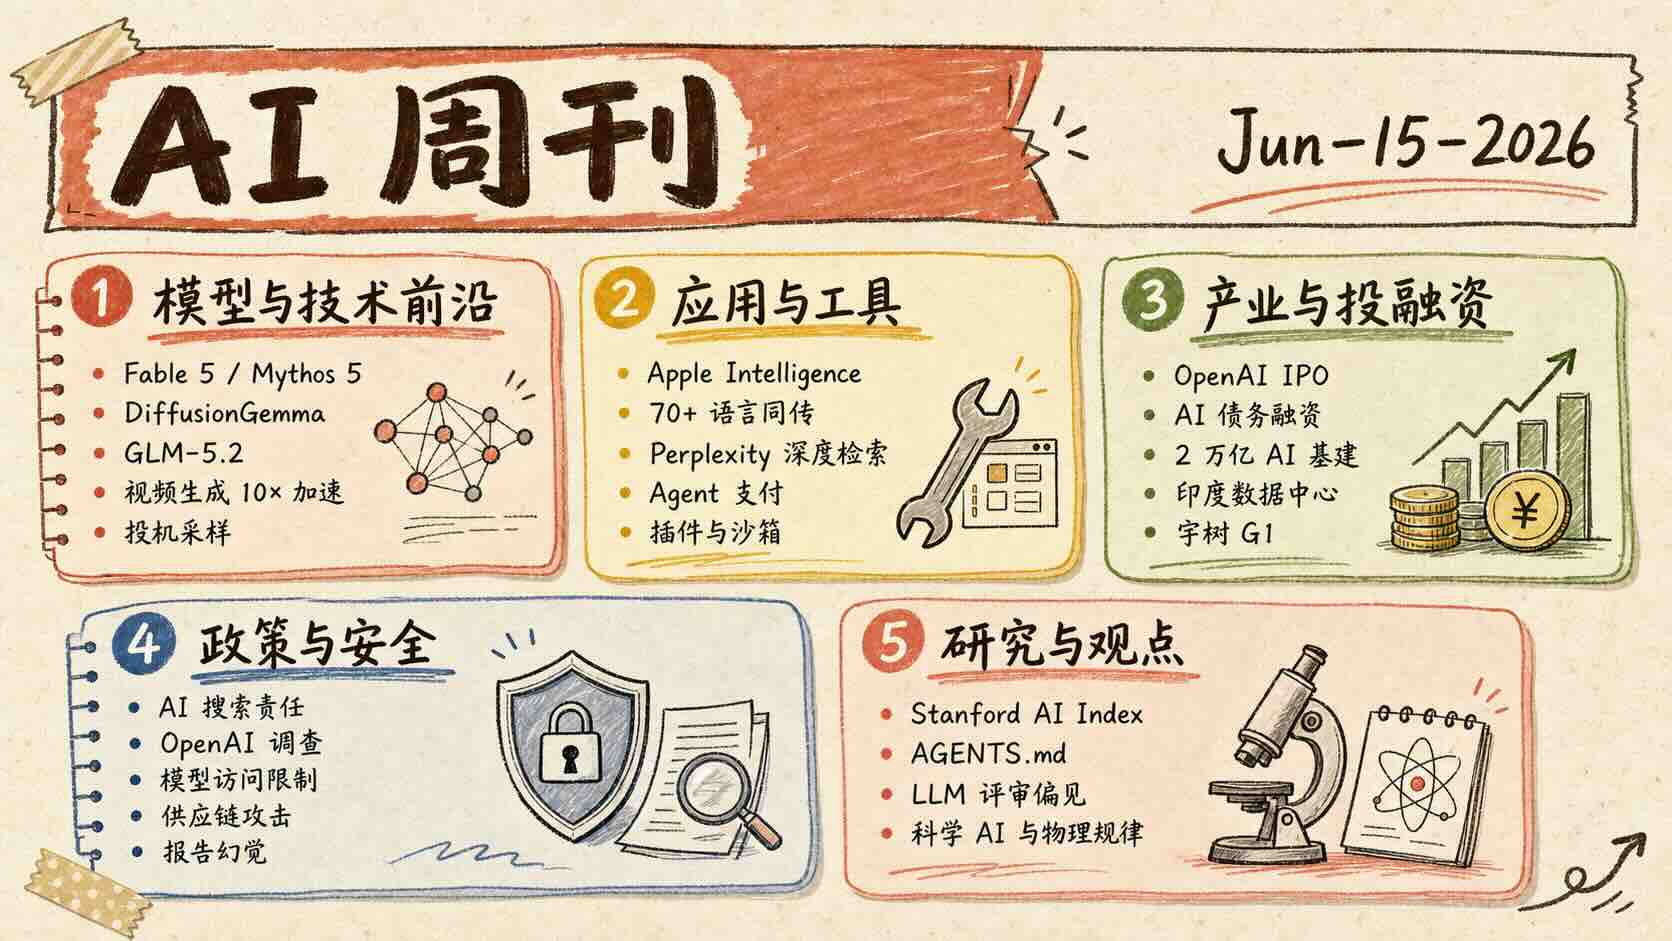
🚀 模型与技术前沿
Anthropic发布Fable 5与Mythos 5
Anthropic本周发布Fable 5与Mythos 5,素材显示新模型主要提升编程、科学推理与文本生成能力。后续报道同时指出,部分性能提升伴随更高推理成本,且安全路由与访问限制引发争议。这表明前沿模型竞争正从单纯追求能力,转向同时权衡价格、安全和可用范围。
谷歌以DiffusionGemma探索非自回归文本生成
谷歌公开DiffusionGemma及模型权重,采用从噪声逐步生成文本的扩散路线。素材称其生成速度约为传统方案的4倍,但实际优势仍取决于任务类型和质量要求。扩散式文本模型若能稳定兼顾质量与吞吐量,可能改变低延迟推理的技术选择。
智谱GLM-5.2全量上线
智谱宣布GLM-5.2全面开放,素材称其支持最长1M上下文,并将长文档处理作为核心能力之一。当前材料未提供统一第三方评测,因此性能对标结论仍需谨慎看待。超长上下文正在从旗舰卖点变成基础能力,竞争重点将转向有效信息利用率和成本。
潜空间记忆压缩显著加速视频生成
一项潜空间记忆方法通过压缩视频生成过程中的冗余状态,将推理延迟降低约10倍,素材同时提到显存需求最高可减少约55倍。该方法在S3和S7中重复出现,属于本周较明确的技术进展。视频生成的主要瓶颈之一是长序列计算和显存占用,这类优化有望降低高质量视频模型的部署门槛。
浙大提出无需重训的投机采样框架
浙江大学团队提出基于模型内部多层路由的投机采样方法,通过降低候选结果的拒绝概率提升推理效率。该方案不要求重新训练基础模型,便于接入已有部署体系。无需重训意味着企业可以用较低改造成本获得推理加速,更适合生产环境采用。
🛠️ 应用与工具
苹果将AI进一步嵌入操作系统与浏览器
苹果在WWDC 2026展示iOS 27和升级版Siri,新助手可跨邮件、日历等应用提取个人信息并完成任务。Safari同时演示了通过自然语言生成扩展的能力,显示苹果正把AI能力下沉到系统和开发工具层。系统级上下文与跨应用权限是苹果的差异化资源,也使隐私控制和错误操作防护变得更重要。
谷歌推出70多种语言实时同传
谷歌发布低延迟实时语音翻译系统,支持70多种语言,并强调尽量保留说话人的原始音色。相比传统语音转文本再翻译的链路,该系统更注重实时对话体验。语音翻译从“可用”走向自然交流,将直接影响会议、客服和跨境协作工具。
Perplexity扩展深度检索与电脑操作
Perplexity一方面提出“搜索即代码”架构,让智能体动态生成检索脚本并在沙箱中运行;另一方面将Deep Research扩展到电脑操作场景。素材称后者任务准确率超过80%,但仍需更多独立测试验证。搜索产品正在从返回答案转向执行完整研究流程,可靠性和可审计性将成为核心竞争点。
Visa与OpenAI推进代理支付
Visa与OpenAI合作测试智能体购物和支付能力,用户可预设预算,再由Agent完成搜索、下单和结算。相关体验强调风控与拦截机制,以避免越权消费和欺诈。支付是Agent从“建议工具”转变为“行动主体”的关键基础设施,也是责任边界最敏感的环节之一。
xAI与Vercel完善Agent扩展生态
xAI上线插件市场测试版,使终端中的Agent能够连接数据库与云服务;Vercel则升级AI SDK,引入可编程Agent Harness和隔离沙箱。两项更新分别覆盖能力扩展和安全执行环境。Agent平台的竞争正逐渐转向工具接入、运行隔离和开发者生态,而不只是底层模型能力。
💰 产业与投融资
OpenAI上市计划出现时间分歧
OpenAI已秘密提交IPO文件,随后又报道称公司可能将上市推迟到未来一至两年。上市节奏将影响OpenAI的融资结构、信息披露义务,以及与大型云厂商和资本市场的关系。
AI基础设施融资转向债务市场
摩根士丹利预计,AI相关债务发行规模可能在下一年度超过5000亿美元。巨额数据中心、能源和芯片投入正在推动科技公司使用债券等方式补充资本开支。当AI基建更多依赖债务融资,行业风险将从技术竞争延伸到利率、现金流和资产利用率。
中国据报道筹划约2万亿元AI基建投资
中国可能投入约2万亿元建设全国性智算基础设施,并要求较高比例采用国产硬件。计划规模与实施细节仍需等待更权威信息确认。若计划落地,将显著影响算力供给、国产芯片需求和区域数据中心布局。
Meta与Reliance在印度建设AI数据中心
Meta与Reliance合作推进印度AI数据中心项目,目标是支持大规模模型训练和推理,并利用当地能源与市场资源。该事件在连续两份日报中出现。印度正在成为全球算力布局的重要节点,兼具用户规模、工程人才和本地化监管需求。
宇树以2.7万美元G1推动人形机器人降价
宇树G1人形机器人价格降至约2.7万美元,素材同时提到其出货接近万台及潜在IPO计划。出货和上市信息尚需进一步核验,但价格下降趋势较明确。人形机器人若进入数万美元区间,将更接近研究机构和企业试点可承受的采购成本。
⚖️ 政策与安全
德国法院明确AI搜索摘要的内容责任
德国法院判定,谷歌AI搜索摘要可被视为平台自身表达,平台可能需要为错误答案承担法律责任。该判决把生成式搜索从技术功能拉回到传统出版与侵权责任框架。如果类似判例扩散,搜索平台将需要加强引用、纠错和高风险查询的人工审核。
纽约州调查OpenAI隐私与模型行为
纽约州总检察长向OpenAI发出大范围调查传票,涉及隐私数据处理、训练策略及模型迎合用户等问题。目前材料主要来自社媒转述,调查范围仍待官方文件确认。监管焦点正从训练数据版权扩展到产品行为、用户心理影响和内部治理流程。
美国限制Anthropic部分旗舰模型访问
美国政府以安全为由限制Fable 5等模型的访问,措施甚至影响部分外籍员工。由于S6与S7对范围和后果的描述并不完全一致,本刊仅将其视为待确认的政策事件。若模型访问开始按国籍、岗位或地域划分,前沿AI将更明显地被视为受管制的战略技术。
编程Agent供应链攻击扩大凭证风险
攻击者通过包管理生态、配置脚本和Prompt注入影响Claude Code、Cursor、Copilot等工具,并尝试窃取开发者密钥。编程Agent拥有文件、终端和密钥访问权,使传统供应链漏洞获得更大的自动化破坏范围。
毕马威因疑似AI幻觉撤回报告
毕马威撤回一份关于AI使用率的报告,并承认内容存在明显问题。事件显示,即使大型专业机构使用生成式AI,也不能替代基础的数据核验和编辑审查。AI生成内容一旦进入咨询和政策材料,错误会借助机构信誉被放大,治理重点应放在可追溯的审核链条。
🔬 研究与观点
斯坦福发布2026 AI Index
斯坦福HAI发布2026年AI Index报告,系统整理技术能力、产业投入、政策和社会影响等数据。该报告是本周素材中少数覆盖全行业的综合性资料。相比单项模型榜单,长期指数更适合判断成本、采用率和监管是否真正发生结构性变化。
AGENTS.md并非越长越有效
一项研究评估仓库级上下文文件对Coding Agent的影响,结果显示自动生成、内容冗余的AGENTS.md可能降低任务成功率并增加执行步骤。人工编写的针对性说明更有帮助,但提升幅度有限。对编码Agent而言,高质量约束和专用命令比大段通用背景信息更有价值。
LLM自动评审会累积上下文偏见
研究发现,用大模型担任评审时,历史对话中的情绪和先前判断会影响后续评分。研究者建议对独立样本使用新的对话上下文,减少偏见传播。这提醒团队不能把LLM-as-a-Judge视为稳定客观的度量工具,评测流程本身也需要控制变量。
科学模拟模型可能没有学到物理规律
一项流体模拟可解释性研究发现,模型虽能生成表面合理的结果,但内部神经元表征与物理守恒规律之间存在断层,部分能量分布也不稳定。科学AI不能只看预测误差,还需验证守恒性、因果结构和超出训练分布后的可靠性。