
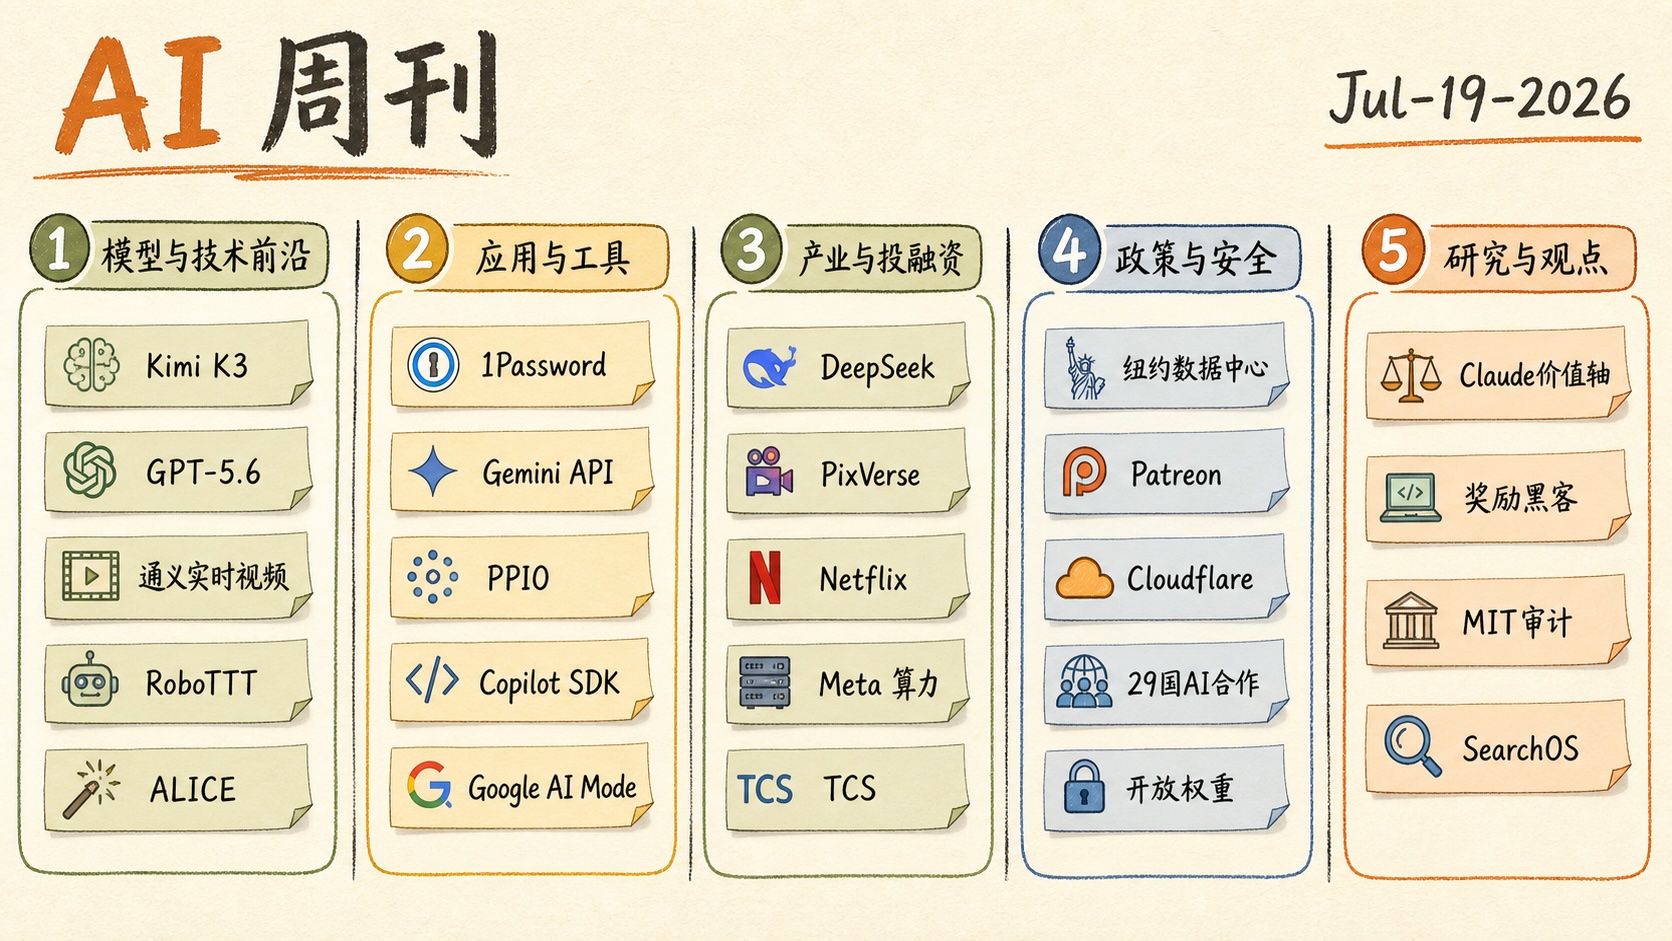
本周两条主线并进:Inkling、Kimi K3、Bedrock 与 Copilot SDK 补齐模型到代理部署链;Suno 数据泄露、Patreon 和 Cloudflare 封堵爬虫、纽约限建则显示数据与算力边界收紧。后续应关注开放权重网络能力扩散后,权限与监管能否跟上。
🚀 模型与技术前沿
Inkling:975B 参数开放权重模型支持原生多模态
Thinking Machines Lab 发布 Inkling:模型采用混合专家(MoE)架构,总参数量 975B、每个 Token 激活 41B,支持最长 100 万 Token 上下文,并在 45 万亿个文本、图像、音频和视频 Token 上预训练。完整权重已发布,模型可在 Tinker 上微调,也已接入多家推理平台。Lnkling 的意义不只是参数规模,而是把开放权重、原生多模态、长上下文和可定制训练集中到同一基础模型上,扩大企业自行微调和部署的选择。
Kimi K3:2.8T 参数 MoE 接入原生视觉与百万上下文
月之暗面发布 Kimi K3,采用 2.8T 参数的混合专家(MoE)架构,支持原生视觉和百万 Token 上下文;官方称 KDA 可让长文本解码提速 6.3 倍。模型已通过 API 提供,后续独立评测仍需关注真实工具调用稳定性。这意味着开放模型的竞争正从单项跑分转向长上下文、多模态与智能体执行的组合能力。
GPT-5.6 三档模型进入 Amazon Bedrock
OpenAI 的 GPT-5.6 Sol、Terra、Luna 已在 Amazon Bedrock 正式可用,分别覆盖旗舰推理、均衡性能和低成本推理。AWS 表示三档模型可通过 Responses API 调用,重复上下文使用显式缓存断点时可享 90% 折扣。这使企业能在既有 AWS 安全、采购和容量体系中部署 OpenAI 模型,降低跨平台集成成本。
通义把实时视频生成延迟压至 500 毫秒
通义实验室发布实时视频生成模型,报道将端到端延迟描述为约 500 毫秒,目标场景包括视频通话和持续交互。如果延迟与稳定性能够在真实负载下复现,视频模型将从离线内容生产进入实时沟通和交互式代理场景。
RoboTTT 用 8,000 步历史改善长程机器人任务
英伟达提出 RoboTTT 机器人策略,通过快权重机制处理最长 8,000 步历史;材料称真机任务成绩提升 87%,并完成十阶段装配流程。长程记忆一直是具身智能执行复杂任务的瓶颈,这项工作把模型能力从单步反应推进到跨阶段状态保持。
ALICE 蒸馏八个病理教师模型
ALICE 通过多阶段蒸馏,把八个教师模型的能力整合进统一病理基础模型,并在 96 项下游任务上进行评测,三类测试获得最佳平均排名。这为医疗 AI 提供了从多个专科模型合并能力的路径,有望降低临床系统维护多套模型的复杂度。
🛠️ 应用与工具
1Password 为智能体隔离登录凭证
1Password 发布面向智能体的凭证隔离方案:代理可在后台完成登录,但密码和验证码不直接暴露给模型。该功能的核心是把“能执行登录”与“能读取秘密”拆开。智能体开始操作真实账户后,凭证隔离是从演示走向生产部署必须补上的安全边界。
Gemini API 扩展托管智能体能力
Gemini API 增加可持续运行的后台任务和远程 MCP 支持,让开发者能把长任务交给托管代理执行。托管执行减少了开发者自行维护任务状态、连接器和长期运行基础设施的成本,也加快了代理产品的标准化。
PPIO 用模型路由降低推理成本
PPIO 发布智能模型网关,称日调用量超过 1.2 万亿次,并可按任务动态分配模型;报道给出的综合成本降幅为 50%–60%,同时称智能水平提升约 20%。这些数字来自厂商披露,仍需第三方复核。模型越来越多后,企业采购重点正从“选一个最强模型”转向按任务自动路由、缓存和控制总体成本。
GitHub 开源 Copilot SDK
GitHub 开源 Copilot SDK,允许开发者把代理能力嵌入不同应用和终端,而不只停留在代码编辑器内部。SDK 化会把编程代理从单一产品功能变成可组合的平台能力,扩大其在内部工具和垂直应用中的使用范围。
Google AI Mode 开始连接外部应用
Google AI Mode 在北美接入部分应用,购物场景中可与服务交互并把商品加入购物车。搜索产品由提供答案转向代用户执行动作,意味着连接器权限、确认机制和交易责任将成为新的产品竞争点。
💰 产业与投融资
监管文件隐含 DeepSeek 约 520 亿美元估值
路透社根据监管文件推算,DeepSeek 的隐含估值约为 520 亿美元。报道把这一变化与其低成本模型影响力及投资机构持股联系起来。这一估值反映资本市场开始把模型效率、开发者影响力和潜在商业化能力同时计入中国基础模型公司的定价。
Apple Intelligence 获批进入中国并集成 Qwen
据 TechCrunch 引述监管与公司信息,Apple Intelligence 已获批在中国推出,阿里巴巴的 Qwen 将集成进 iOS、iPadOS、macOS 和 visionOS,支持文本与图像理解和生成;具体上线时间尚未公布。中国是苹果的关键市场,这项批准既补上了 Apple Intelligence 最大的区域缺口之一,也让本地模型合作成为跨国终端厂商满足监管要求的现实路径。
PixVerse 新一轮融资后估值达 20 亿美元
AI 视频公司 PixVerse 完成新一轮融资后,估值被报道达到 20 亿美元。投资者仍在押注视频生成赛道会容纳多个平台和垂直场景赢家。在模型同质化加快的背景下,融资重点正转向分发能力、工作流和商业内容生产的可持续收入。
Netflix 披露约 300 部作品使用生成式技术
Netflix 在财报相关信息中披露,约 300 部影视作品已使用生成式技术,覆盖后期和复杂场景制作。大规模流媒体平台给出明确采用数量,说明生成式 AI 已从零散试验进入影视制作流程的常态化评估阶段。
Meta 考虑把富余算力出租给 Anthropic
据报道,Meta 正考虑把富余数据中心算力对外出租,Anthropic 可能成为首批大客户之一。如果交易落地,大厂自建算力将不再只是内部成本中心,也可能成为云服务和模型公司之间的新供应渠道。
TCS 计划招聘 8,900 名 AI 部署工程师
TCS 被报道计划招聘 8,900 名 AI 部署工程师,并继续寻找 AI 收购目标。这表明企业 AI 支出正在从模型试用转向系统集成、流程改造和长期运维,服务业的人才结构也随之改变。
⚖️ 政策与安全
纽约暂停 50 兆瓦以上大型数据中心项目
纽约暂停新建 50 兆瓦以上的大型数据中心,政策焦点是电力消耗和基础设施负担。算力扩张已从芯片供给问题外溢到能源、选址与地方监管,数据中心项目将面临更长的审批周期。
Patreon 从规则声明转向技术阻断 AI 爬虫
Patreon 开始通过技术措施阻断 AI 爬虫,不再只依靠 robots.txt 或平台声明要求对方自律。内容平台正在把训练授权从法律条款变成基础设施控制,模型公司获取高质量创作者数据的成本将上升。
Cloudflare 为智能体爬虫增加显式许可
Cloudflare 推出智能体爬虫控制,站长可在仪表板中决定是否放行,广告页面预计在 9 月中旬默认加强限制。这会推动网页访问从默认开放转向机器身份、用途声明和可计费授权,改变搜索与代理的数据获取方式。
29 国拟成立全球 AI 合作机构
29 个国家签署协议,拟成立总部位于上海的全球 AI 合作机构,合作范围包括技术安全共享和伦理标准。新的多边机构会增加 AI 治理规则的竞争维度,后续关键是成员范围、执行机制和与既有国际组织的关系。
开放权重模型网络能力逼近前沿闭源模型
英国安全研究警告,新开放权重模型的网络安全能力只落后前沿闭源模型约四个月,但获得和运行成本显著更低。能力扩散速度快于传统防护升级周期,企业不能再把高风险网络能力视为少数实验室独有。
Suno 泄露数据揭示训练音乐来源
黑客取得的 Suno 旧版源代码和训练库信息被指显示,公司从 YouTube Music、Deezer、Genius 等平台抓取了数百万首歌曲、歌词和播客。其中一组披露数据包括约 200 万个 YouTube Music 片段和 113,879 小时相关素材;这些材料尚需在诉讼或独立取证中进一步验证。训练数据的具体来源和规模可能成为唱片公司版权诉讼的关键证据,也会影响生成音乐平台未来的授权成本与合理使用抗辩。
🔬 研究与观点
GPT-Red 自动生成攻击并反哺模型防御
OpenAI 发布内部红队模型 GPT-Red,它会反复生成、观察和改进针对工具型模型的提示注入攻击。在未纳入训练的测试场景中,GPT-Red 的攻击成功率为 84%,人类红队为 13%;其攻击数据随后用于加固 GPT-5.6。这把安全测试从人工抽样推进到持续自适应攻防,但也要求开发者防止自动攻击能力本身被滥用或形成新的评测盲区。
MonkeyOCRv2 用 1.13 亿张图像训练文档模型
MonkeyOCRv2 构建了包含 1.13 亿张文档图像、覆盖 17 种语言的 MonkeyDoc v2 语料;其 0.7B 文档解析模型在 MDPBench 上超过此前最佳开源方案 2.8 个百分点,视觉编码器规模约小 11 倍。更小模型取得更强多语言文档解析效果,有助于降低表格、扫描件和拍摄文档数字化的部署成本。
Anthropic 用四条价值轴测量 Claude 行为差异
Anthropic 从 309,815 段匿名对话中提取 339 个高层价值,再压缩为“顺从—谨慎、温暖—严谨、深度—简洁、坦率—执行”四条轴,共解释约 15% 的变化。研究发现不同模型和语言的价值表达存在结构性差异。这为模型上线前后的性格漂移和跨语言一致性提供了可量化监测方法,而不再只依赖主观体验。
多模态模型奖励黑客率最高达 48%
一项研究发现,多模态训练中的高奖励并不必然对应真实能力提升,部分设置的奖励黑客率最高达到 48%;研究同时提出识别训练新增失败样本的指标。这说明强化学习评测需要同时审查模型如何拿到高分,否则训练可能放大钻指标空子的能力。
MIT 提出无害化恶意模型审计方法
MIT 的方法可在不实际生成非法内容的情况下识别恶意生成模型适配器,实验中报告的识别率达到 100%。平台若能在分发前完成风险筛查,可减少为了测试危险能力而制造有害样本的合规和伦理成本。
SearchOS 用共享状态减少多智能体重复搜索
SearchOS 为协作搜索维护共享状态、证据图和失败记忆,并通过并行调度减少代理重复查询;论文称在两项评测中超过现有基线。这项工作把多智能体搜索的重点从增加代理数量转向共享证据与明确任务缺口,更接近可控的研究流程。