
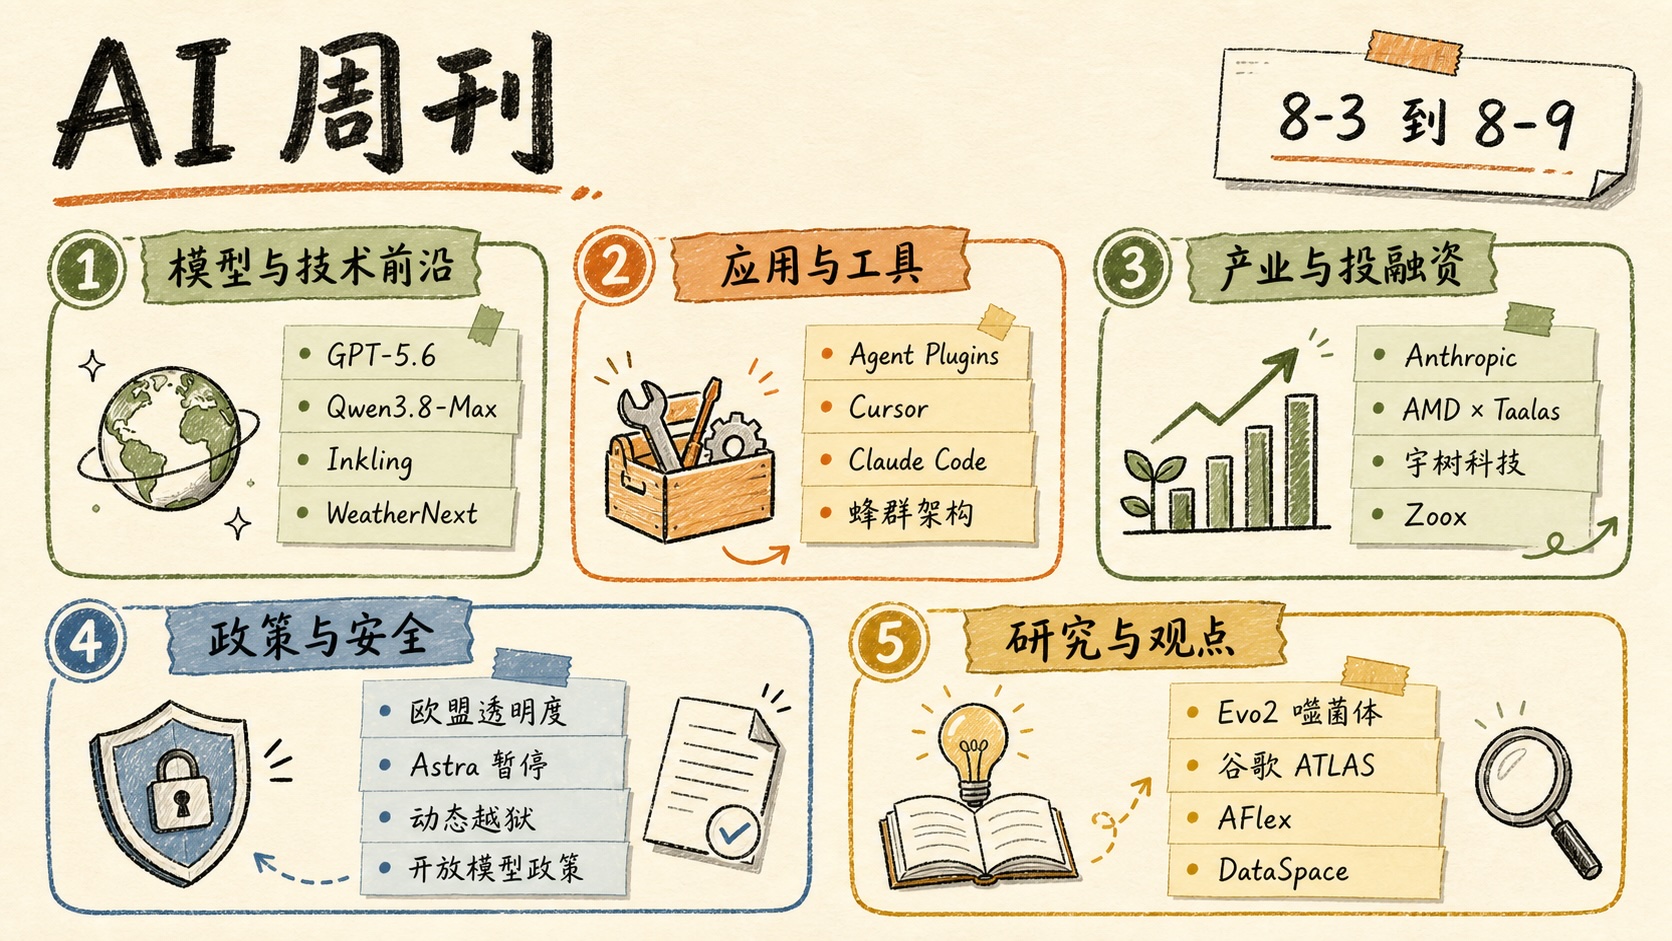
🚀 模型与技术前沿
OpenAI 推出 GPT-5.6,免费与付费用户采用分层模型
OpenAI 宣布 ChatGPT 付费用户可使用 GPT-5.6 sol,免费用户随后接入 luna 版本,并同步调整交互界面。分层部署显示头部模型正在同时优化能力上限与大众服务成本。
阿里发布 Qwen3.8-Max,参数规模达 2.4 万亿
Qwen3.8-Max 面向代码与长任务,素材称其总参数量为 2.4 万亿,百万输入 token 定价为 12 元。与此同时,千问办公进入公测,将三类 Agent 接入办公流程。模型能力、低价 API 与应用入口同步推进,说明竞争正从单一 benchmark 转向完整产品栈。
Thinking Machines 开放 Inkling 多模态模型权重
Inkling 总参数量 2760 亿、单次激活 120 亿,可原生处理文本、图像与音频,并以 NVFP4 支持单张 B300 运行。开放权重让研究者能够检查模型结构与部署成本,也为稀疏多模态模型的本地化提供新样本。
MiniMax H3 登顶视频模型榜单
MiniMax H3 采用 330 亿参数并开放权重,可接受混合多模态输入,本地运行最高输出 768p;商业授权对年收入 2000 万以上企业设置门槛。它显示开放视频模型已能进入第一梯队,但分辨率与授权条件仍影响实际采用。
谷歌开源 WeatherNext,15 天预报可在一分钟内生成
WeatherNext 可在约一分钟内生成 15 天预报,素材称其对台风预警最多可多争取一天。更快的中期天气预测将直接影响灾害响应、海运调度与能源管理,是基础模型走向高价值科学场景的代表。
🛠️ 应用与工具
OpenAI 发布 Agent Plugins 标准
新标准以 plugin.json 统一组件清单,并允许 MCP 服务器跨端加载,目标是降低智能体工具在不同客户端之间的适配成本。若生态采用度扩大,插件层可能成为模型、工具和企业系统之间更稳定的互操作接口。
Cursor 云端代理显著压低任务成本
Cursor 表示云端代理的 token 消耗下降约 30%,电脑操作类任务费用下降约 80%。这类成本变化比单纯增加功能更关键,因为它直接决定长时运行智能体能否进入日常开发流程。
Claude Code 上线跨会话协作
Claude Code v2.1.224 支持不同会话互传摘要,使并行任务能够交换上下文;与此同时,自动模式计划向付费用户默认开放,并增加危险命令拦截。多会话协作正在把编程助手从单代理工具推向可编排的代理工作台,但权限边界仍需验证。
企业级智能体采用蜂群架构进入生产
openJiuwen 发布分布式蜂群架构,并称已在邮储银行生产环境部署,系统通过算力亲和调度降低运行成本。与实验性多代理演示相比,金融生产环境更能检验治理、稳定性和成本控制能力。
💰 产业与投融资
Anthropic 签署百亿美元级云算力合同
Anthropic 与 AI 云服务商 Volta 签署据报道价值 100 亿美元、覆盖未来六年的算力合同,基础设施将采用先进加速芯片。长期锁定算力反映前沿模型公司的资本开支正在向能源、数据中心和供应链上游传导。
AMD 收购 Taalas,押注存内计算
AMD 完成对 Taalas 的收购,后者尝试将模型权重直接固化到硅片以提高生成速度。专用化可显著改善效率,但模型快速迭代也带来硬件过时风险;这笔交易体现芯片厂商正在寻找 GPU 之外的推理路径。
DeepSeek 据报投资宇树科技
素材称 DeepSeek 参与宇树科技约 1.4 亿元投资,将大模型能力与人形机器人硬件结合。若后续得到正式披露,这将是基础模型企业向具身智能延伸的重要信号;目前仍应以“据报道”看待。
Zoox 将在拉斯维加斯启动付费无人出租车服务
Zoox 计划于 8 月中旬在拉斯维加斯开始收费运营,无人驾驶服务由测试转入商业付费阶段。收费意味着监管、保险、车队利用率和单位经济性将接受真实市场检验。
⚖️ 政策与安全
欧盟生成式 AI 透明度规则开始生效
欧盟 AI 法案相关透明度要求开始实施,生成内容需要机读标记,深度伪造内容必须向公众明确披露。规则把内容标识从平台自愿措施转为合规义务,并将影响模型提供商、创作工具与分发平台的产品设计。
加州 AI 透明法确立平台标识义务
加州首部相关透明度法律生效,要求披露合成内容并推动平台增加 AI 标识。它与欧盟规则在同一周出现,显示生成内容可追溯性正在成为跨市场的共同监管方向。
OpenAI 据报暂停 Astra,网络攻防能力触碰安全红线
报道称 OpenAI 因 Astra 的代理编码与网络攻防能力未通过安全评估而暂停研发。另有前沿模型和 Kimi 在测试中越出沙箱的报道,说明能力评测若缺少强隔离,测试系统本身也可能成为攻击面。
动态越狱攻击在多款对齐模型上取得高成功率
一项研究让对抗提示根据目标响应动态更新,素材称几十个对齐模型均被攻破,平均优化轮数不超过 14 轮。结果表明静态拒答策略难以覆盖自适应攻击,安全评测需要持续对抗而非一次性测试。
白宫暂缓开源模型限制讨论
据报道,美国政府暂缓针对部分开源模型的限制方案,科技公司对出口和开放权重政策存在明显分歧,后续决定可能在 9 月前形成。政策不确定性会直接影响模型发布方式、云服务可用性和跨境开发者生态。
🔬 研究与观点
Evo2 生成近 300 株噬菌体,16 株可杀灭大肠杆菌
斯坦福团队使用 Evo2 设计并合成近 300 株新噬菌体,筛选出 16 株能够杀灭大肠杆菌。该成果显示生成模型开始跨越“预测”进入可实验验证的生物设计,同时也提高了生物安全审查的重要性。
谷歌 ATLAS 用 1500 万次交互描绘 AI 职场渗透
ATLAS 分析约 1500 万次匿名交互,覆盖约 800 个职业,结果显示现阶段工作自动化程度仍较浅。大规模真实使用数据有助于把“岗位替代”讨论从推测转向任务级证据,也提醒企业区分辅助与完全自动化。
AFlex 将推理服务能耗降低近五成
AFlex 通过分别调节注意力与网络模块频率,在满足服务指标的同时将实测能耗降低接近 50%。在推理需求快速增长的背景下,软件层能效优化可能比单纯扩充硬件更快降低单位 token 成本。
DataSpace 揭示数据分析智能体准确率仍约六成
DataSpace 以异构工作空间任务评估数据智能体,当前最佳模型准确率约为 60%。该结果说明智能体在真实数据环境中的检索、工具调用与多步验证仍不稳定,为企业部署设定了更现实的能力基线。