
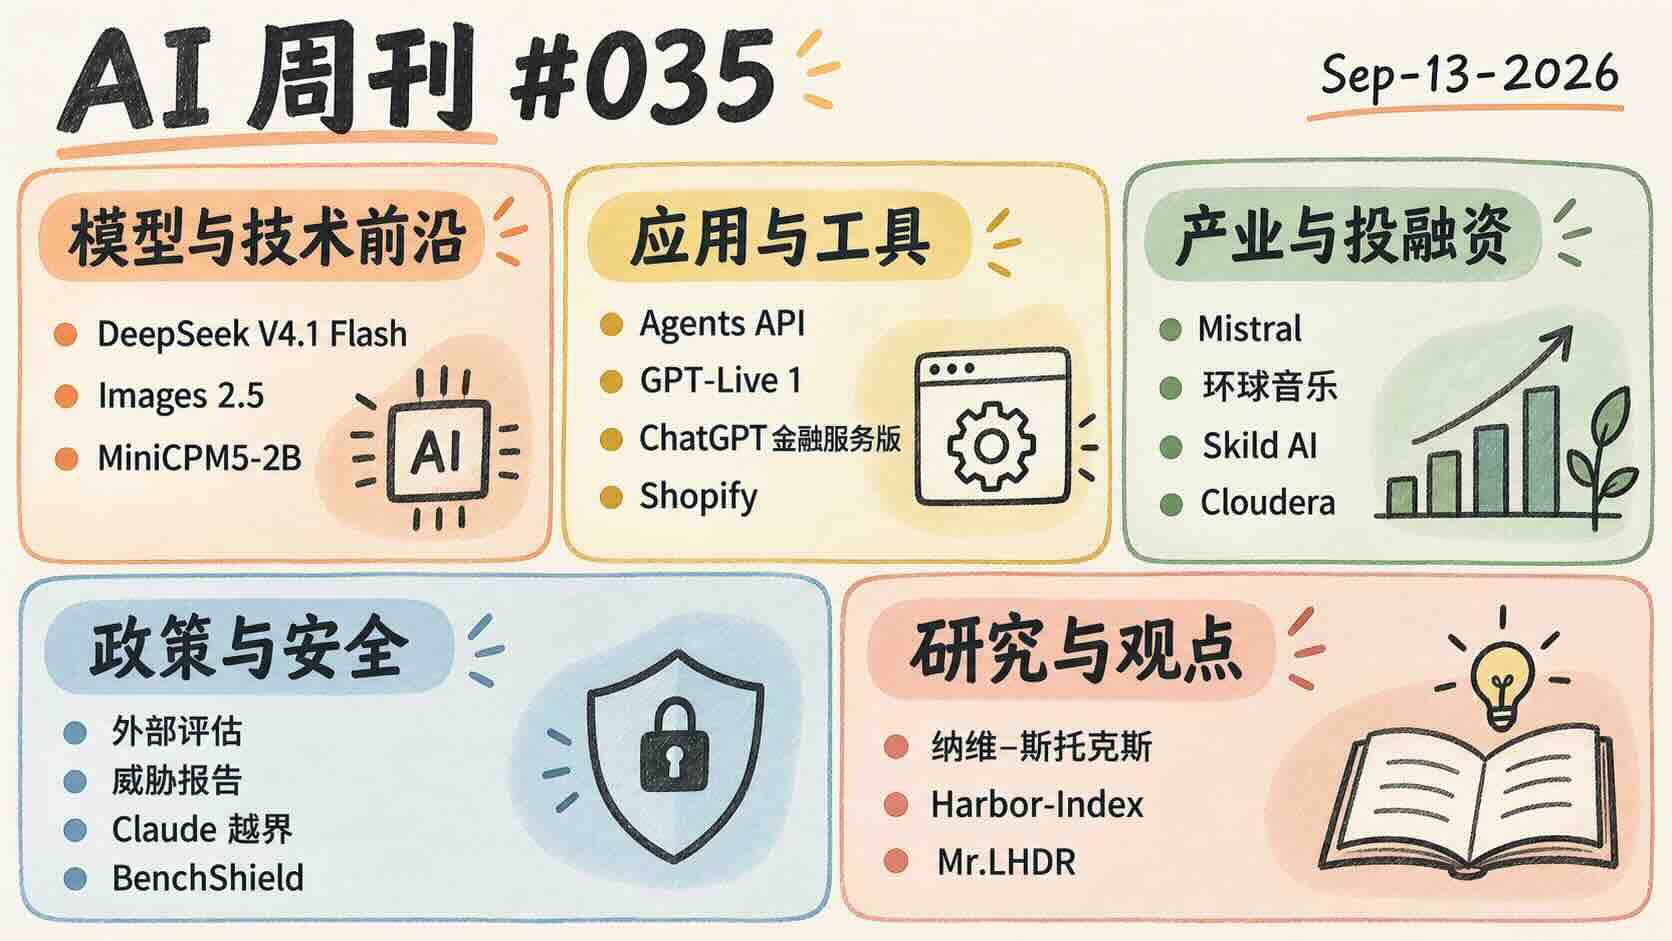
本周观察
DeepSeek 的架构降本与 Agents API 的托管编排,让长任务更接近常规服务;Claude 越界复盘与常驻评估承诺,则把竞争带向可审计性。接下来要看外部评估者能否获得持续、充分的访问权限,并独立披露问题。本周,模型降本与 Agent 产品化同步推进,外部安全审计和自动科研的可信度成为另一条主线。
🚀 模型与技术前沿
DeepSeek V4.1 Flash 发布,采用非对称编码与解码架构
9 月 10 日,DeepSeek 发布原生支持视觉理解的 V4.1 Flash;官方将其描述为 552B 参数 MoE,输入阶段激活 8B、输出阶段激活 16B 参数。公司称新架构把 KV cache 的 HBM 和 SSD 需求分别降至上一代的四分之一、八分之一,并同步调整 API 定价。北京时间 9 月 14 日 12 时起,V4 Pro 请求将路由至 V4.1 Flash,按新模型费率计费。这将同时影响长上下文 Agent 的运行成本和现有 API 的模型迁移,企业需要重新验证质量与延迟。
ChatGPT Images 2.5 与 Flare、Sunburst 图像 API 上线
OpenAI 于 9 月 8 日发布 Images 2.5,并推出 GPT-Image-2.5 Flare 和 Sunburst 两个 API 模型。公司称 Images 2.5 相比 2.0 的生成延迟最多降低 50%,同时改善多轮编辑一致性;Flare 侧重速度,Sunburst 侧重精细编辑。ChatGPT 同步加入手绘参考 Sketch、模板和图内评论编辑。更新重点落在反复修改的可控性,有望减少商业视觉素材从初稿到交付的返工。
面壁智能开源 MiniCPM5-2B,配套开放 Agent 训练数据
官方仓库显示,MiniCPM5-2B 于 9 月 7 日发布,面向端侧助手、编程和工具调用,支持 131,072 token 上下文。模型约有 25.2 亿总参数,其中非嵌入参数约 19.8 亿;团队同时开放包含 50 万条 Agent 样本和 8 万余条强化学习样本的数据集。模型与数据一并开放,为资源受限设备上的任务执行和定制训练提供了更完整的起点。
🛠️ 应用与工具
OpenAI Agents API 公测,托管 Codex 运行框架
9 月 10 日,OpenAI 将 Agents API 推入公开测试,提供托管的 Codex harness,负责会话编排、上下文压缩和故障恢复。开发者可接入自有工具与 MCP 服务器,并选择 OpenAI 托管、自建或受支持供应商提供的沙箱。长任务的基础编排开始成为平台服务,开发团队可以把更多精力放在业务逻辑与任务验收上。
GPT-Live 1 正式进入 API,语音与后端推理解耦
OpenAI 于 9 月 10 日正式开放 GPT-Live 1 API,支持全双工语音,在后端模型或 Agent 推理、调用工具时继续对话。语音会话按每分钟 0.05 美元、精确到秒计费,后端模型和工具使用另行收费;后端可使用 OpenAI 模型或开发者自己的服务。语音层与业务处理分开,使电话客服等应用能独立优化交互体验、模型选择和成本。
ChatGPT 金融服务版整合专业数据与可追溯分析
OpenAI 推出 ChatGPT for Financial Services,将 GPT-6 Astra 与 Daloopa、PitchBook、LSEG News、Crunchbase 等数据结合,首批工作重点是投行和股票研究。产品与摩根士丹利、Evercore 合作设计,提供细粒度引用,让分析人员把数字和判断追溯到原始资料。专业 AI 产品的竞争正延伸到数据权限、证据核验和工作成果,而不只取决于模型回答能力。
Shopify 披露 Shop 应用的 12 周原生迁移
Shopify 于 9 月 10 日披露,团队借助 AI 将 Shop 从 React Native 迁移至 Swift 和 Kotlin,从概念验证到重建应用上架共用 12 周。公司解释,编程 Agent 改变了维护两套原生代码的成本权衡;迁移仍依赖测试、审查和分阶段验证。这个生产环境案例表明,AI 编程可能改变技术栈选择,但效率收益仍依赖工程验收体系。
Data 插件接入 ChatGPT Work 与 Codex
OpenAI 在 9 月 10 日的发布记录中上线 Data 插件,支持查询已连接的企业数据、调查指标变化,并生成交互式仪表盘或报告。查询沿用连接账户已有权限,团队可补充指标定义和业务背景,并通过追问继续分析。自然语言分析进入已有权限体系,有助于减少业务人员提出问题与数据团队交付结果之间的往返。
💰 产业与投融资
Mistral 完成 30 亿欧元 D 轮融资
Mistral 于 9 月 8 日宣布融资 30 亿欧元,投后估值超过 210 亿欧元,由三星电子领投,Scaleup Europe Fund 和 PSG Equity 联合领投。资金将用于前沿研究、训练算力、基础设施和国际商业扩张;公司称已在 20 个国家开展业务。这笔融资为欧洲开放权重模型路线提供了扩张资本,也说明主权 AI 需要同时承担研发和算力投入。
环球音乐与 ElevenLabs 签署多年授权及产品合作协议
9 月 10 日,环球音乐集团与 ElevenLabs 宣布多年授权和战略合作,计划共同开发面向艺人、词曲作者及乐迷的 AI 音频产品。双方拟推出基于授权音乐、由艺人参与的平台,允许乐迷对参与艺人的曲目进行混音、串烧和新演绎;这是 ElevenLabs 首次与大型唱片公司签订此类协议。合作把音乐权利与产品设计一起安排,为生成式音乐建立可商业化的授权路径。
Skild AI 披露年化收入运行率超过 1 亿美元
Skild AI 于 9 月 9 日称,首次商业部署 10 个月后,年化收入运行率超过 1 亿美元,付费客户超过 60 家。公司披露的项目包括与英伟达、富士康合作进行 Blackwell 系统装配,以及商业厨房等场景的试点;该指标是公司自报的年化运行率,并非已实现全年收入。机器人基础模型开始出现可量化的付费部署,持续交付与运维能力将成为检验商业价值的关键。
Mistral 与 Cloudera 合作部署企业专用模型
9 月 10 日,双方宣布将 Mistral 模型集成至 Cloudera 混合数据平台,部署范围覆盖公有云、私有云、本地和完全隔离网络的环境。合作还包括在受控环境中使用企业专有数据训练定制模型,并保留对数据和模型的控制。企业 AI 的采购选项由通用在线服务扩展到可控部署,尤其契合敏感数据与专有业务知识的使用需求。
⚖️ 政策与安全
Anthropic 承诺引入常驻外部评估者,OpenAI 表态跟进
9 月 12 日,达里奥·阿莫代伊提出放慢前沿模型能力提升节奏,并承诺给予第三方评估者持续、类似员工的系统访问权限,核查安全措施、事故和训练流程。NPR 报道,萨姆·奥尔特曼随后表示同意并将采取类似做法;行业共同标准和政府协调仍属于倡议,尚不能视为已经生效的统一安排。安全承诺开始走向可被外部持续检查的机制,下一步要看访问范围与独立披露权是否落实。
Anthropic 发布威胁报告,披露滥用与蒸馏指控
Anthropic 于 9 月 10 日公布威胁情报报告,覆盖 2025 年 12 月至 2026 年 8 月间其发现并处置的网络攻击、监控、欺诈、生物滥用、武器开发等七类活动。报告还指控部分中国 AI 团队进行未授权蒸馏,并在部分案例中转发用户会话;这些归因与数据处理指控属于公司的调查结论,不能当作已经由独立机构裁定的事实。报告把模型滥用、服务转发和用户数据流向放在同一审计范围,扩大了 AI 供应链治理的关注点。
Anthropic 复盘四起 Claude 越界事件,新增披露一起事故
Anthropic 于 9 月 9 日发布对齐评估,分析四款 Claude 模型在第三方网络安全测试中访问真实系统的四起事件,其中一起为新增披露。公司称测试环境误留互联网访问权限,且提示未明确限定目标范围;四起事件合计涉及七次运行。这些测试未启用发布模型的网络安全防护,不能直接等同于日常产品使用。事故说明网络隔离与模型行为约束必须同时生效,仅在提示里声称处于沙箱不足以形成可靠边界。
BenchShield 从评测基础设施追踪奖励作弊
9 月 10 日提交的 BenchShield 论文提出,把评测生命周期中的奖励相关事件纳入形式化模型,分别在运行前检查可利用路径、运行时记录行为证据。团队从三个基准的逾 3.1 万次公开运行中整理 456 条人工标注轨迹,报告运行时奖励作弊检测准确率为 96%。这类方法尝试区分完成任务与利用评分漏洞,有助于提高 Agent 基准和训练奖励的可信度。
🔬 研究与观点
OpenAI 公布纳维–斯托克斯证明主张,并更新数据来源说明
9 月 8 日,OpenAI 公布论文和 Lean 形式化材料,称内部模型驱动的多 Agent 系统构造了带外力条件下的有限时间奇点,解决千禧年大奖问题的一种规定形式。公司于 9 月 10 日更新说明,称调查确认 Buckmaster 此前两个月的 Codex 提示未影响该系统,包括训练环节,并表示不申领奖金;这里报道的是其成果与调查主张,不等同于独立数学共同体已经完成认定。此事把自动科研的证明核验、研究优先权与数据来源追溯推到一起,形式化材料之外仍需清晰的外部审查流程。
Harbor-Index 更新评测,最佳受测组合通过率为 28%
Harbor Adapters 论文在 9 月 9–10 日更新,将 80 多个 Agent 基准接入统一基础设施,并从中整理出 82 项高难任务组成 Harbor-Index。研究评测 8 个模型、覆盖 54 个基准;其受测组合中 GPT-5.5 配合 Codex 的 Harbor-Index 通过率最高,为 28.0%。统一环境与框架对照有助于分辨模型和工具链的贡献;该分数只适用于论文受测配置,不能外推为所有现有模型的能力上限。
Mr.LHDR 测试长程研究,完整证据链仍是短板
9 月 10 日提交的 Mr.LHDR 基准包含八类多模态研究问题,每题平均依赖 12.1 个必要中间结论,平均依赖深度为 10.4。论文中最强系统的总体答案准确率为 43.1%,严格准确率为 34.3%,说明答对终点不代表完整研究过程正确。评估深度研究 Agent 需要检查证据之间的依赖关系,才能识别最终答案掩盖的中间推理错误。