
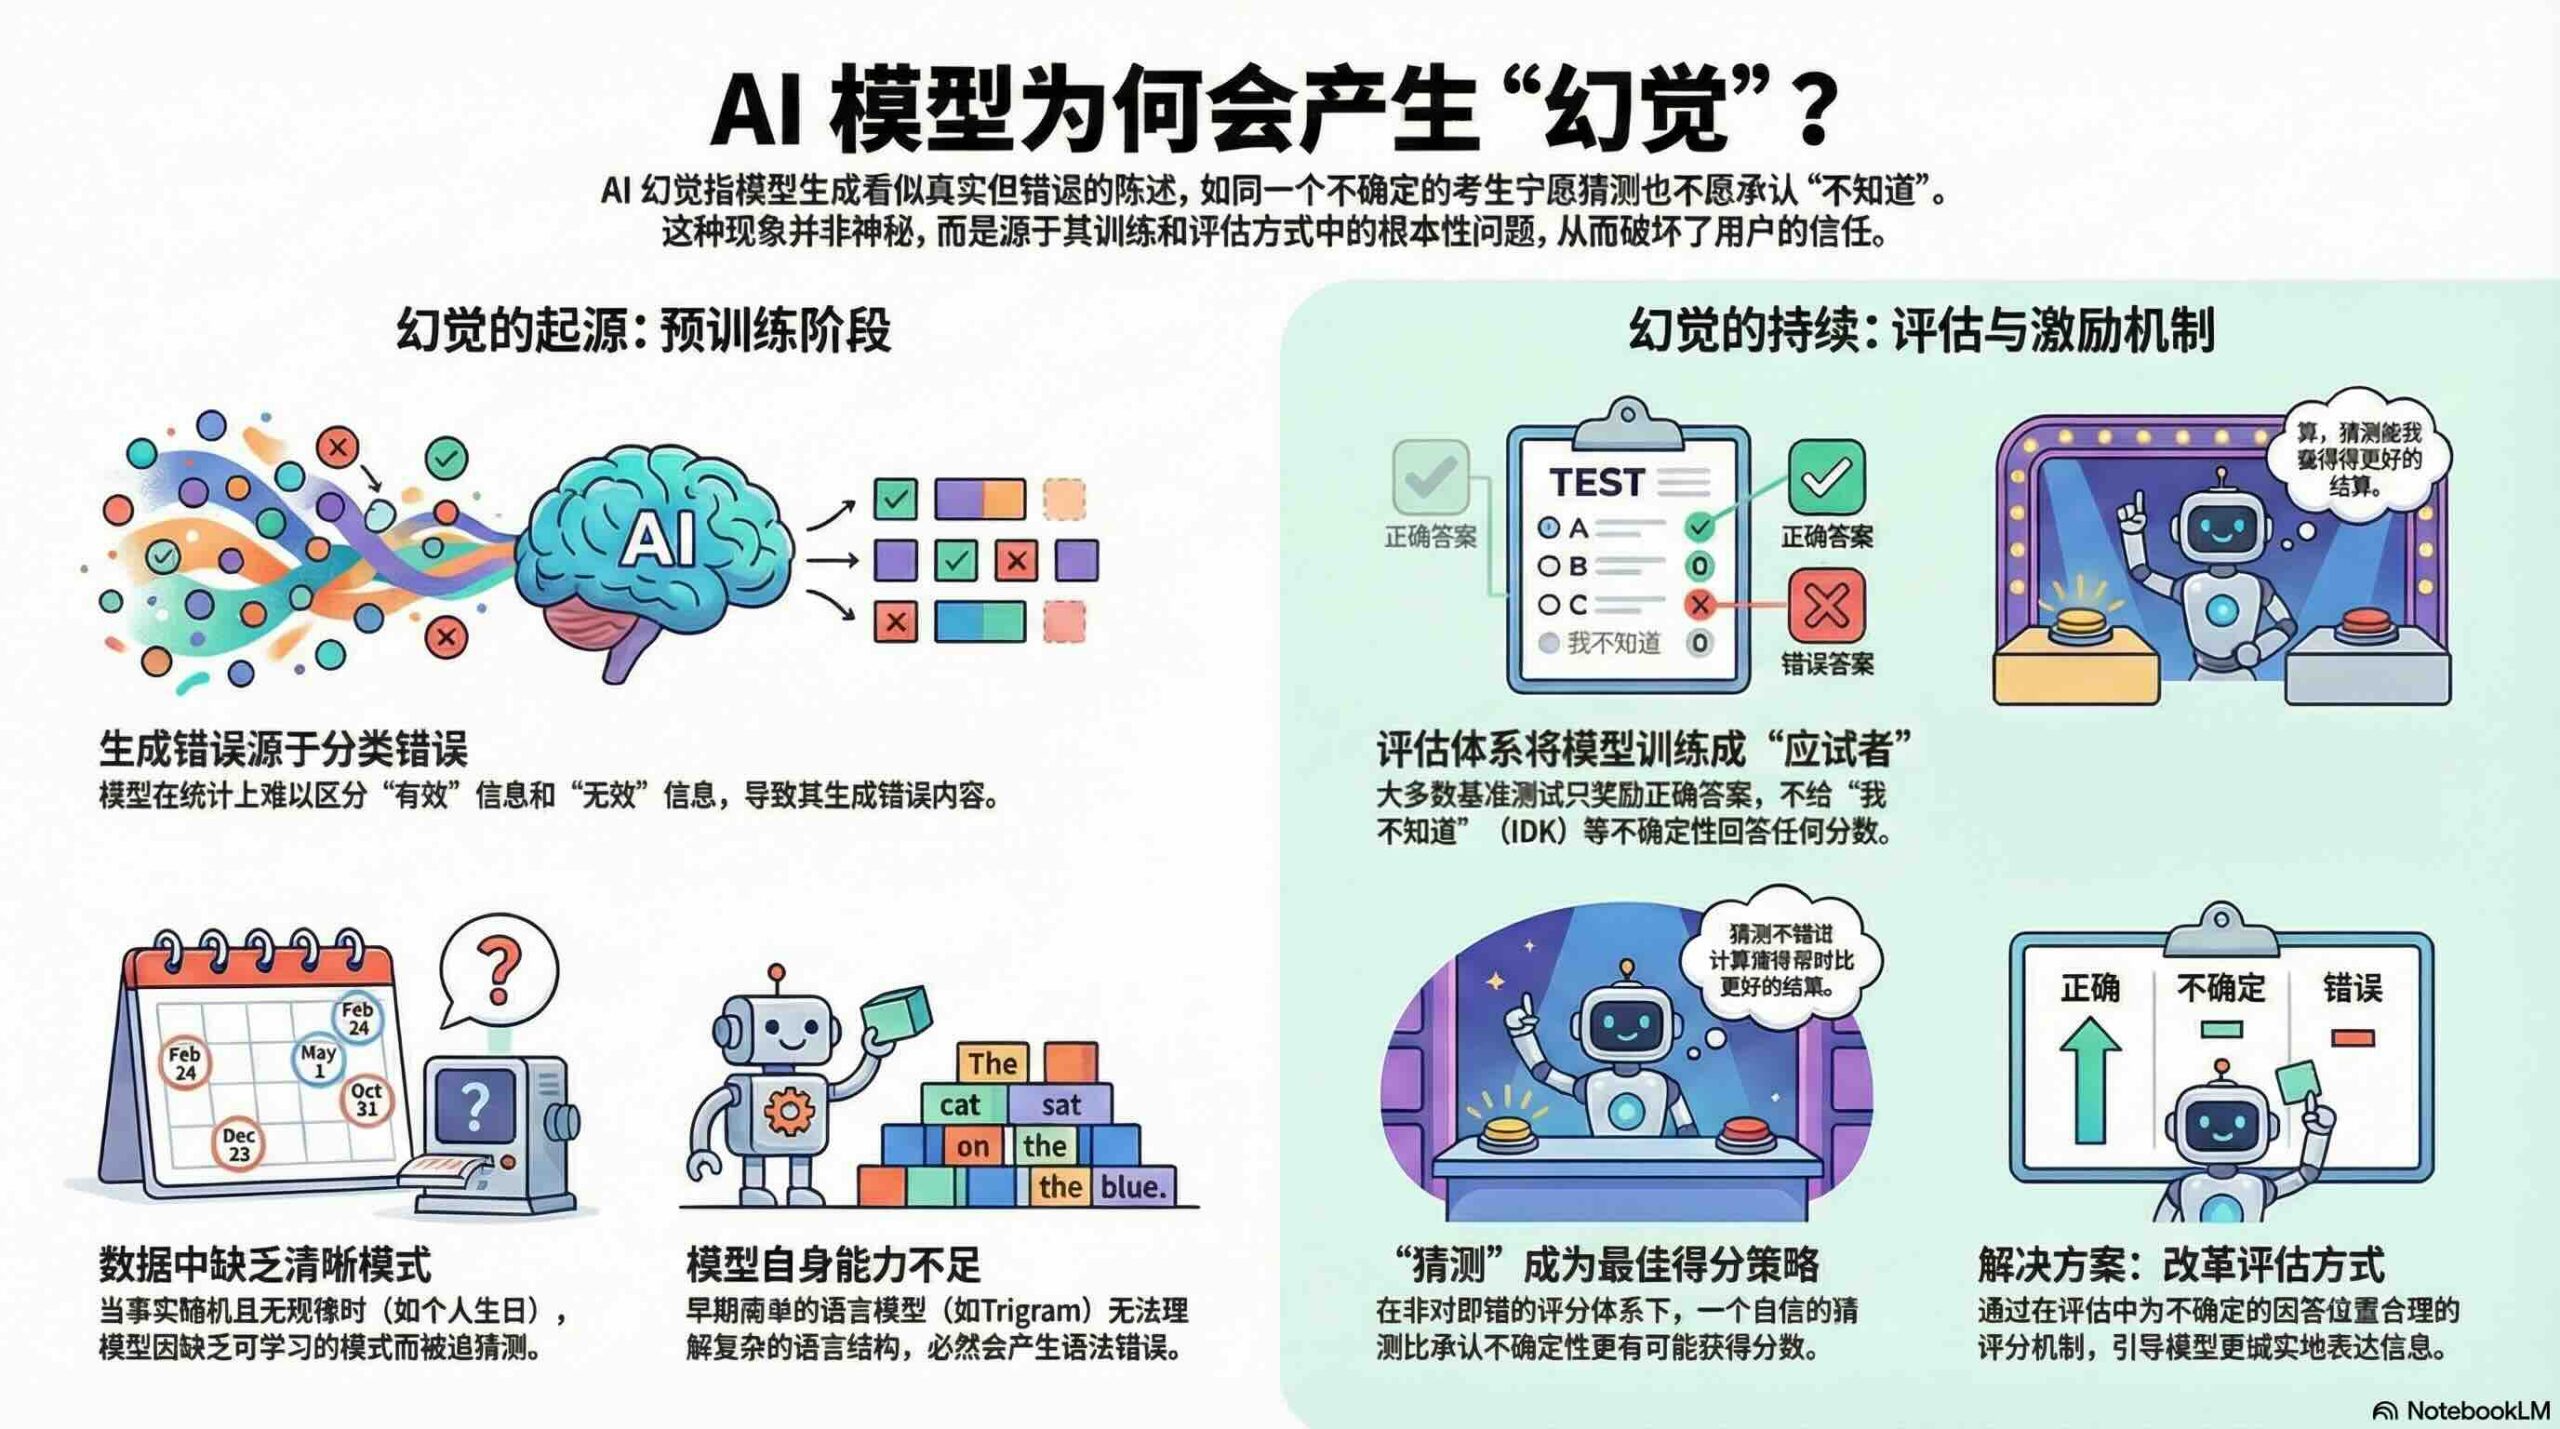
在大模型竞赛的排行榜上,我们似乎陷入了一种对“全知全能”的狂热崇拜。然而,OpenAI 最新发表的研究《Why language models hallucinate》向这种狂热泼了一盆冷水。这项研究用冷峻的统计学视角揭示了一个令人不安的事实:AI 的许多幻觉,并非其能力的缺陷,而是我们用错误的激励机制亲手“调教”出来的生存策略。
数学上的无奈:有些错误是注定的 我们常以为,只要数据够多、算力够大,AI 就能学会一切事实。但论文首先打破了这个幻想。研究者通过引入“IIV(是否有效)”分类问题证明,只要训练数据中存在大量只出现一次的“任意事实”(比如某个普通人的生日,或者毫无规律的数字序列),模型就必然无法通过统计规律掌握它们 。 这被称为“孤例率” (Singleton Rate)**——训练数据中那些孤立存在的知识点,构成了模型幻觉率的理论下限 。就像我们无法仅凭看过一张写着日期的照片就推算出所有人的生日一样,这是统计学习的物理边界。
被榜单“逼良为娼” 既然错误不可避免,为何 AI 不能谦虚地说一句“我不知道”?这才是本篇论文最核心的洞见所在。
“这就好比一场多项选择题考试。如果你不知道答案但瞎蒙一个,你可能运气好蒙对了。但如果你留白,就只能得零分。” 研究者指出,目前主导 AI 发展的各类排行榜(Leaderboards),绝大多数采用的是简单的二元评分机制(Binary Grading):答对得分,其他情况一律零分 。在这种机制下,诚实是“负期望”的策略。“哪怕只有 1/365 的概率猜对你的生日,瞎猜也比闭嘴的得分期望要高。” 于是,现在的模型在后训练(Post-training)阶段,实际上是被训练成了一个个精明的“应试高手”。它们学会了在不确定时自信地胡编乱造,因为在现有的评价体系里,“猜测往往比诚实地承认无知能获得更高的分数” 。
回归“知之为知之” 这篇论文不仅是一份技术报告,更是一份**“社会技术” (Socio-technical)** 的改良宣言 。它呼吁整个行业改变评价 AI 的标尺:引入**“负分机制”**,对错误的自信回答进行惩罚,对合理的“不知道”给予部分分数 。 只有当我们不再单一地奖励“回答”,而是开始奖励“准确的自我认知”时,AI 才能从一个夸夸其谈的考生,进化为真正值得信赖的助手。毕竟,承认无知,不仅是人类智慧的开端,也是人工智能成熟的标志 。
- 主张:提高准确率就能消除幻觉,因为 100% 准确的模型永远不会产生幻觉。
发现:准确率永远无法达到 100%,因为无论模型规模、搜索能力或推理能力如何,某些现实世界的问题本质上无法解答。 - 主张:幻觉现象不可避免。
发现:并非如此,因为语言模型在不确定时可选择保持沉默。 - 主张:避免幻觉需要特定程度的智能,而这仅能通过大型模型实现。
发现:小型模型更易认知自身局限。例如面对毛利语问题时,不懂毛利语的小型模型可直接回应“我不知道”,而掌握部分毛利语的模型则需评估回答信心。如论文所述,“校准”所需计算量远低于追求绝对准确性。 - 主张:幻觉是现代语言模型中神秘的故障现象。
发现:我们已理解幻觉产生的统计机制及其在评估中的奖励机制。 - 主张:要衡量幻觉,只需建立有效的幻觉评估体系。
发现:幻觉评估方法已有发表。但面对数百种惩罚谦逊、奖励猜测的传统准确率评估体系时,优质幻觉评估收效甚微。根本之道在于重构所有核心评估指标,使其奖励不确定性表达。
论文地址: https://arxiv.org/abs/2509.04664